GPT-5.6 Luna führend bei UI-Grounding
Das Modell erreichte alle 24 Ziele und erzielte mit 0,771 die höchste durchschnittliche Box-IoU. Außerdem hatte es in diesem Durchlauf mit 0,0057 $ die niedrigsten gemeldeten Grounding-Kosten.
Repeato-Forschung · LLM-Vision-Benchmark
Ein ausschließlich auf Screenshots basierender Benchmark für UI-Testautomatisierung: interaktive Elemente finden, das Fehlen eines Elements erkennen, sichtbare Layoutfehler identifizieren und die operativen Kosten einer Antwort erfassen.
Sechs deterministische Screens. Vierundzwanzig Grounding-Ziele. 9 API-Modelle. Ein fokussierter Pilot, kein Ranking.
Erkenntnisse aus dem Pilotprojekt
Diese Erkenntnisse beschreiben pro Fall eine beibehaltene Antwort auf einem kleinen synthetischen Korpus. Sie liefern nützliche Signale für die nächste Ausgabe, sind aber weder allgemeine Modellrankings noch Aussagen zur Stabilität.
Das Modell erreichte alle 24 Ziele und erzielte mit 0,771 die höchste durchschnittliche Box-IoU. Außerdem hatte es in diesem Durchlauf mit 0,0057 $ die niedrigsten gemeldeten Grounding-Kosten.
8 von 9 Modellen erreichten eine balancierte Genauigkeit von 100 %. Der Track eignet sich als Plausibilitätsprüfung für fehlende Elemente, unterscheidet in dieser Pilotversion jedoch die meisten Modelle kaum.
Es war das einzige Modell mit einer balancierten Genauigkeit von 100 % bei fehlerfreien und fehlerhaften Layouts. Die Genauigkeit bei Fehlerkategorien lag bei 67 % – ein Problem zu erkennen und es präzise zu benennen, sind unterschiedliche Aufgaben.
Was das für die Testautomatisierung bedeutet
Exakte Interaktion, kontinuierliche Beobachtung und semantische Interpretation stellen unterschiedliche Leistungsanforderungen. Es sollte nicht erwartet werden, dass eine einzige Computer-Vision-Technik alle drei Bereiche optimiert.
Die lokale Computer-Vision-Schleife von Repeato kann den Bildschirm mit 20 Hz prüfen – einmal alle 50 ms. Eine Anfrage an ein Vision-Language-Modell benötigt für Bildübertragung, Inferenz und Netzwerk-Roundtrip üblicherweise 2–10 Sekunden. Dieser Unterschied ist entscheidend, wenn ein Test das Erscheinen eines Elements erkennen, auf das Ende einer Bewegung warten oder reagieren muss, bevor ein flüchtiger Zustand verschwindet.
Lokale visuelle Fingerabdrücke können kontinuierlich nach aufgezeichneten Zielen suchen und handeln, sobald der Bildschirm bereit ist. Remote-Modellanfragen in derselben Frequenz zu wiederholen, wäre unpraktisch.
Lokales Matching erfordert weder einen Netzwerk-Roundtrip noch die Verfügbarkeit eines Anbieters und verursacht keine API-Kosten pro Anfrage. Bildschirme bleiben auf dem Arbeitsplatzrechner, und derselbe Algorithmus kann offline ausgeführt werden.
Die LLM-Bildverarbeitung spielt ihre Latenz aus, wenn ein Test eine semantische Beurteilung benötigt: Texte oder Zahlen interpretieren, dynamische Inhalte verstehen oder Konzepte wie einen Aufwärtstrend in einem Diagramm prüfen.
Nutze lokale Computer Vision für die hochfrequente Steuerschleife – Ziele finden, warten, interagieren und visuell vergleichen. Wechsle gezielt zu KI-Vision, wenn die Prüfung tatsächlich Sprachverständnis oder semantisches Verständnis erfordert.
Experimente
Grounding, Elementvorhandensein und UI-Integrität beantworten unterschiedliche Fragen und verwenden separate Metriken. Der Pilot fasst sie nicht zu einer Gesamtbewertung zusammen.
Experiment 1 · UI-Grounding
Jedes Modell erhielt 24 interaktive Ziele auf sechs fehlerfreien Pilot-Screens. Ein schema-valider Punkt innerhalb des Ziels zählt als Treffer; Box-IoU misst die Lokalisierungspräzision. Erweitere eine Zeile für Ergebnisse auf Szenarioebene.
Methodik
Vier Ziele pro Screenshot aus gängigen interaktiven UI-Elementtypen.
Der vorhergesagte Klickpunkt liegt innerhalb der Zielbox.
Mittlere IoU und Anteil der Vorhersagen mit IoU ≥ 0,5.
Rate schema-valider Antworten; ein Durchlauf ergibt keinen Stabilitätswert.
Experiment 2 · Elementvorhandensein
Eine ausgewogene Aufgabe prüft, ob Modelle plausibel wirkende, nicht vorhandene Elemente ablehnen, statt sie selbstbewusst zu erfinden.
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 1.29 s | $0.3636pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 7.45 s | $0.1414pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 7.55 s | $3.2402pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 7.82 s | $2.3426pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 9.85 s | $7.4788pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 7.50 s | $2.2346pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 9.27 s | $2.9915pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 0% | 7.79 s | $7.0680pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 92% | 100% | 83% | 17% | 15.01 s | $2.3602pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
Ein Durchlauf pro Fall; keine Konfidenzintervalle oder Stabilitätsaussagen. Die Gesamtkosten werden auf 1.000 beibehaltene Fälle hochgerechnet, damit unvollständige Durchläufe nicht künstlich günstig erscheinen. Zeilen mit weniger als 12 Antworten enthalten weiterhin eine kleinere Fallauswahl und sind nicht direkt mit vollständigen Zeilen vergleichbar.
Methodik
Pro fehlerfreiem Bildschirm eine bekanntermaßen vorhandene und eine plausible, aber nicht vorhandene Abfrage.
Die ausgewogene Genauigkeit gewichtet vorhandene und nicht vorhandene Fälle gleich.
Recall, Spezifität und Falsch-Positiv-Rate zeigen die Fehlerrichtung.
found=true oder found=false; kein Lokalisierungswert.
Experiment 3 · UI-Integrität
Gepaarte, intakte Steuerelemente und gezielt eingebaute Fehler prüfen Erkennung, Fehlerklassifizierung und Lokalisierung, ohne diese Ergebnisse mit Grounding zu vermischen.
| 67 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 58% | 17% | 100% | 0% | 2.44 s | $0.8251pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 92 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 83% | 67% | 100% | 50% | 8.36 s | $0.2389pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 92% | 83% | 100% | 67% | 9.02 s | $5.2075pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 75 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 75% | 83% | 67% | 67% | 8.43 s | $3.8341pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 83 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 83% | 67% | 100% | 67% | 10.15 s | $11.5029pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 100% | 100% | 100% | 67% | 7.40 s | $2.7465pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 92 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 83% | 83% | 83% | 67% | 10.52 s | $4.7403pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 92 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 92% | 83% | 100% | 67% | 11.91 s | $11.6632pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 100 % gültig12/12 Fälle · 0 fehlgeschlagene Versuche | 92% | 100% | 83% | 67% | 21.75 s | $3.0450pro 1.000 beibehaltene Fälle | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
Ein Durchlauf pro Fall; keine Konfidenzintervalle oder Stabilitätsaussagen. Die Gesamtkosten werden auf 1.000 beibehaltene Fälle hochgerechnet, damit unvollständige Durchläufe nicht künstlich günstig erscheinen. Zeilen mit weniger als 12 Antworten enthalten weiterhin eine kleinere Fallauswahl und sind nicht direkt mit vollständigen Zeilen vergleichbar.
Methodik
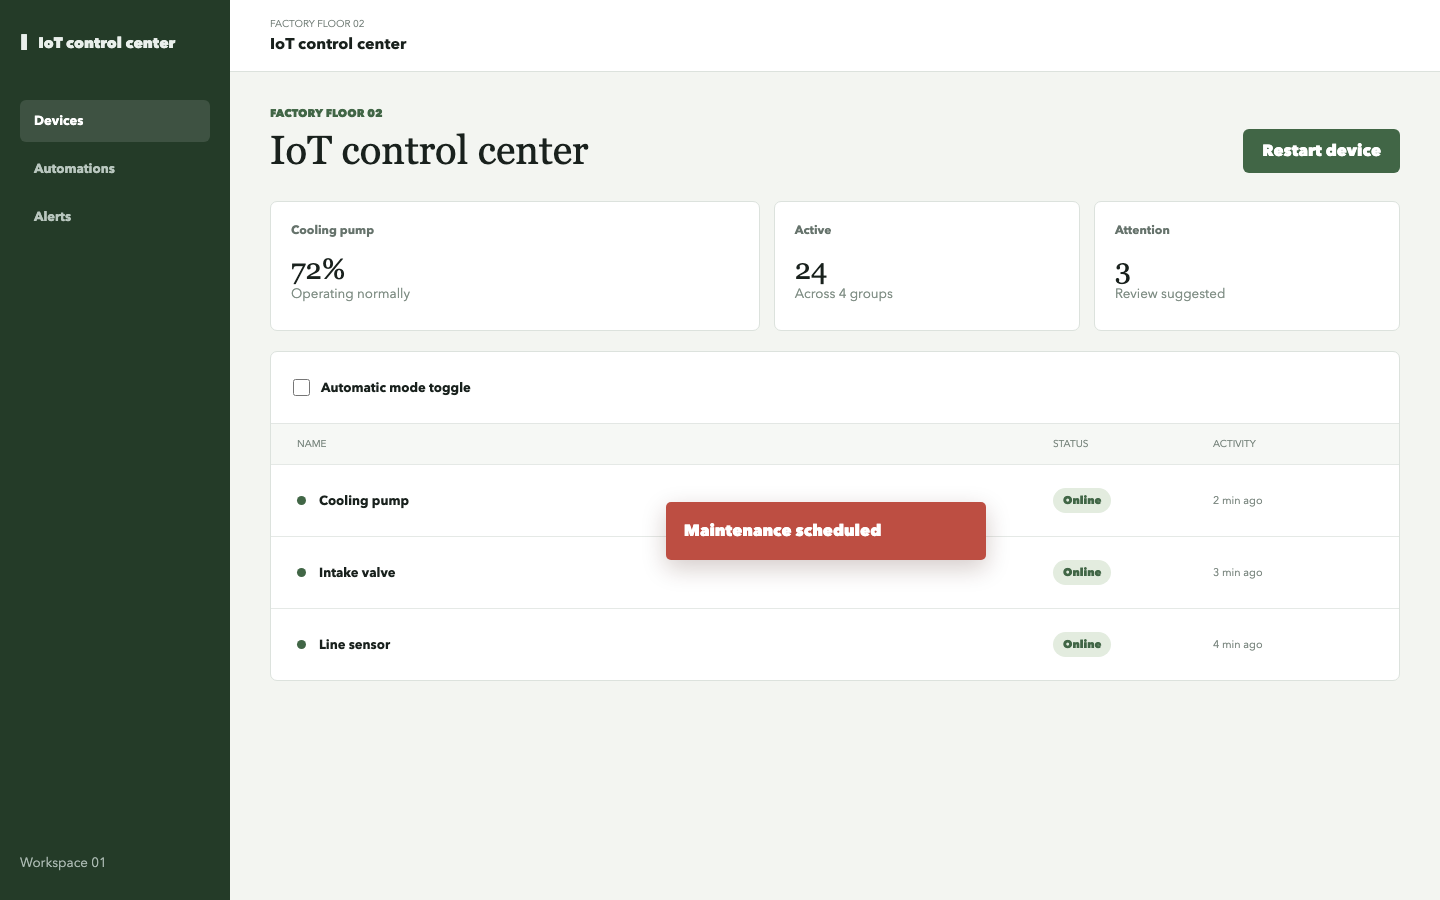
Gepaarte fehlerfreie und fehlerhafte Szenen decken sechs objektive Arten von Layout-Fehlern ab.
Ausgewogene Genauigkeit, Recall, Spezifität und Falsch-Positiv-Rate.
Genauigkeit der Fehlerkategorie nach erfolgreicher Erkennung.
IoU der vorhergesagten Box im Vergleich zu browserbasierten Fehlerregionen.
Unveränderter Datensatz
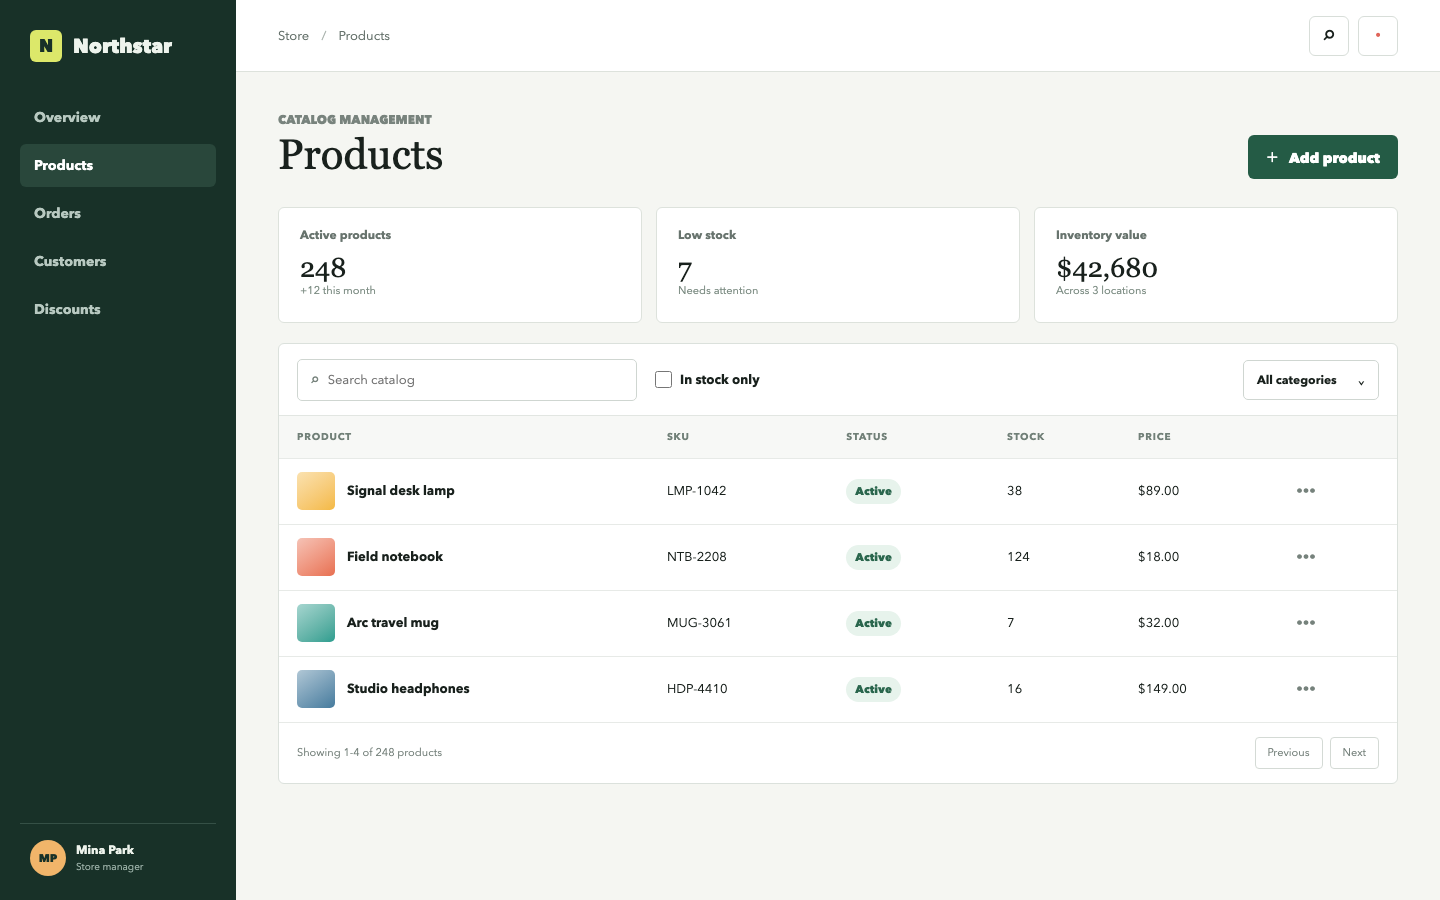
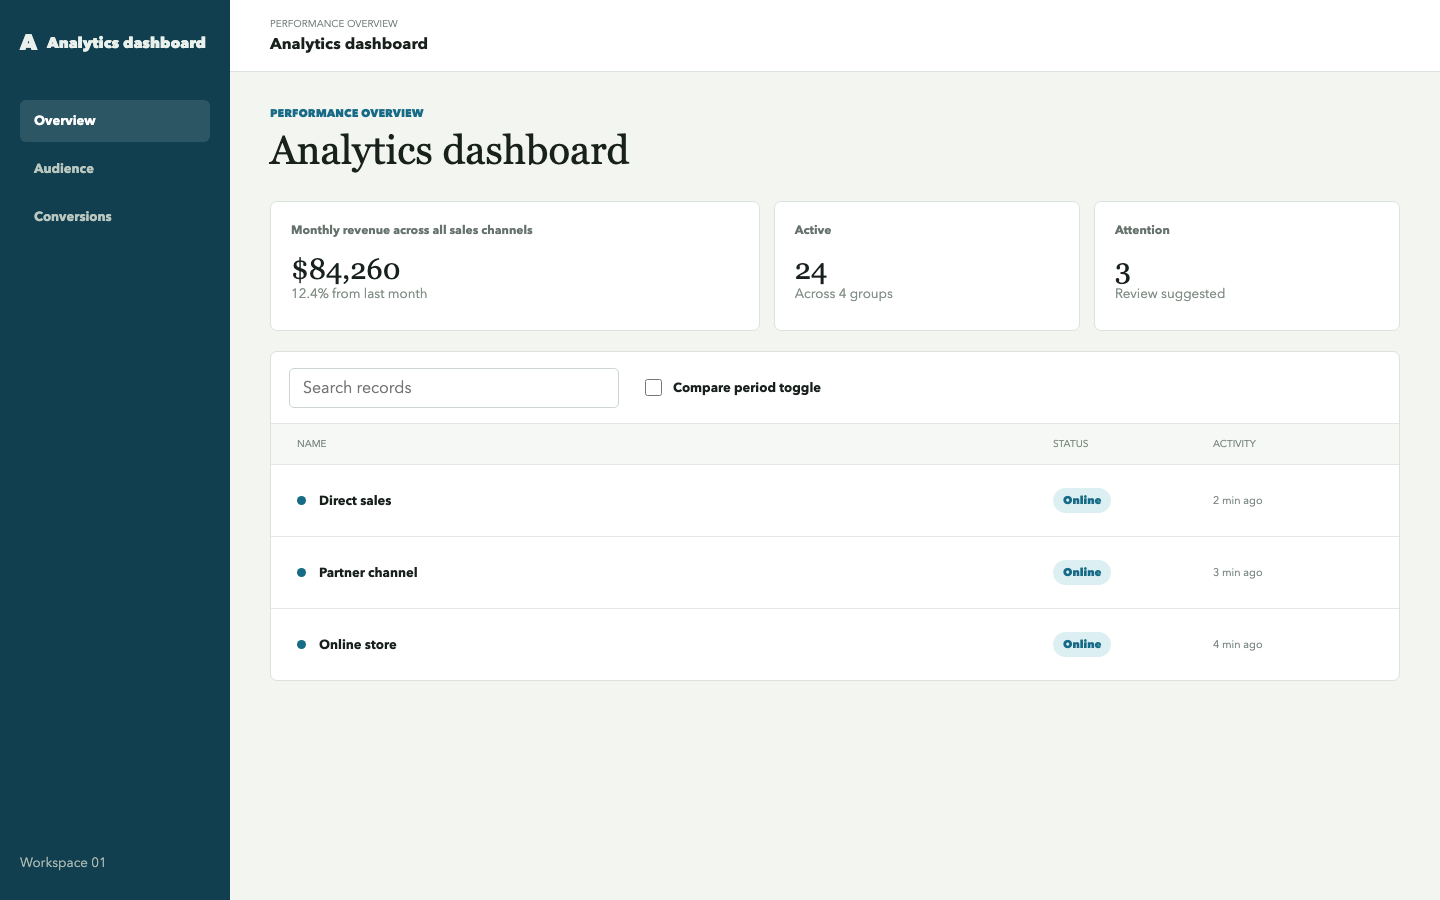
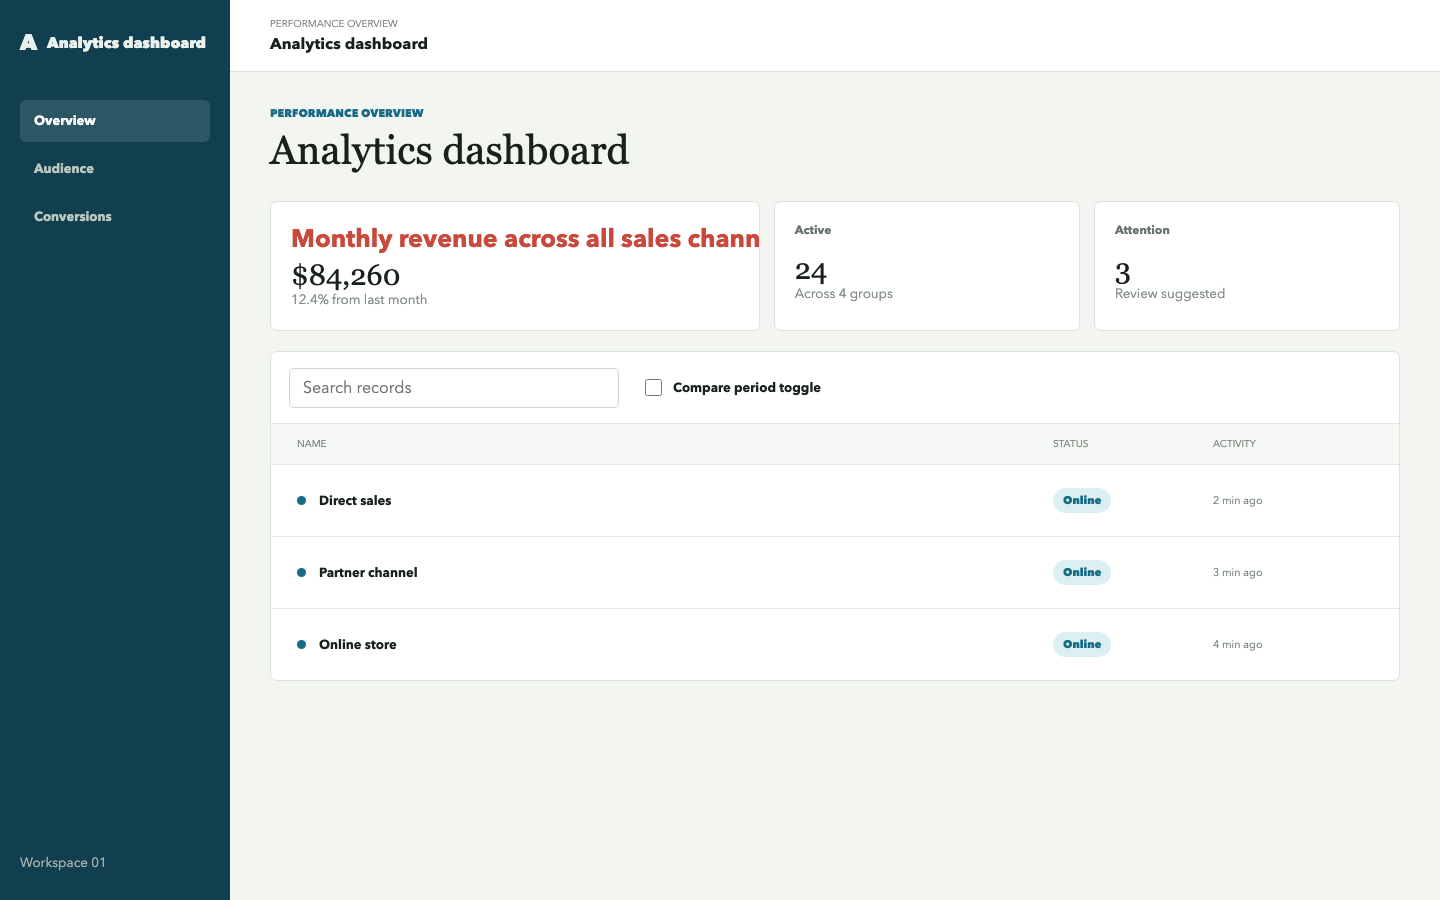
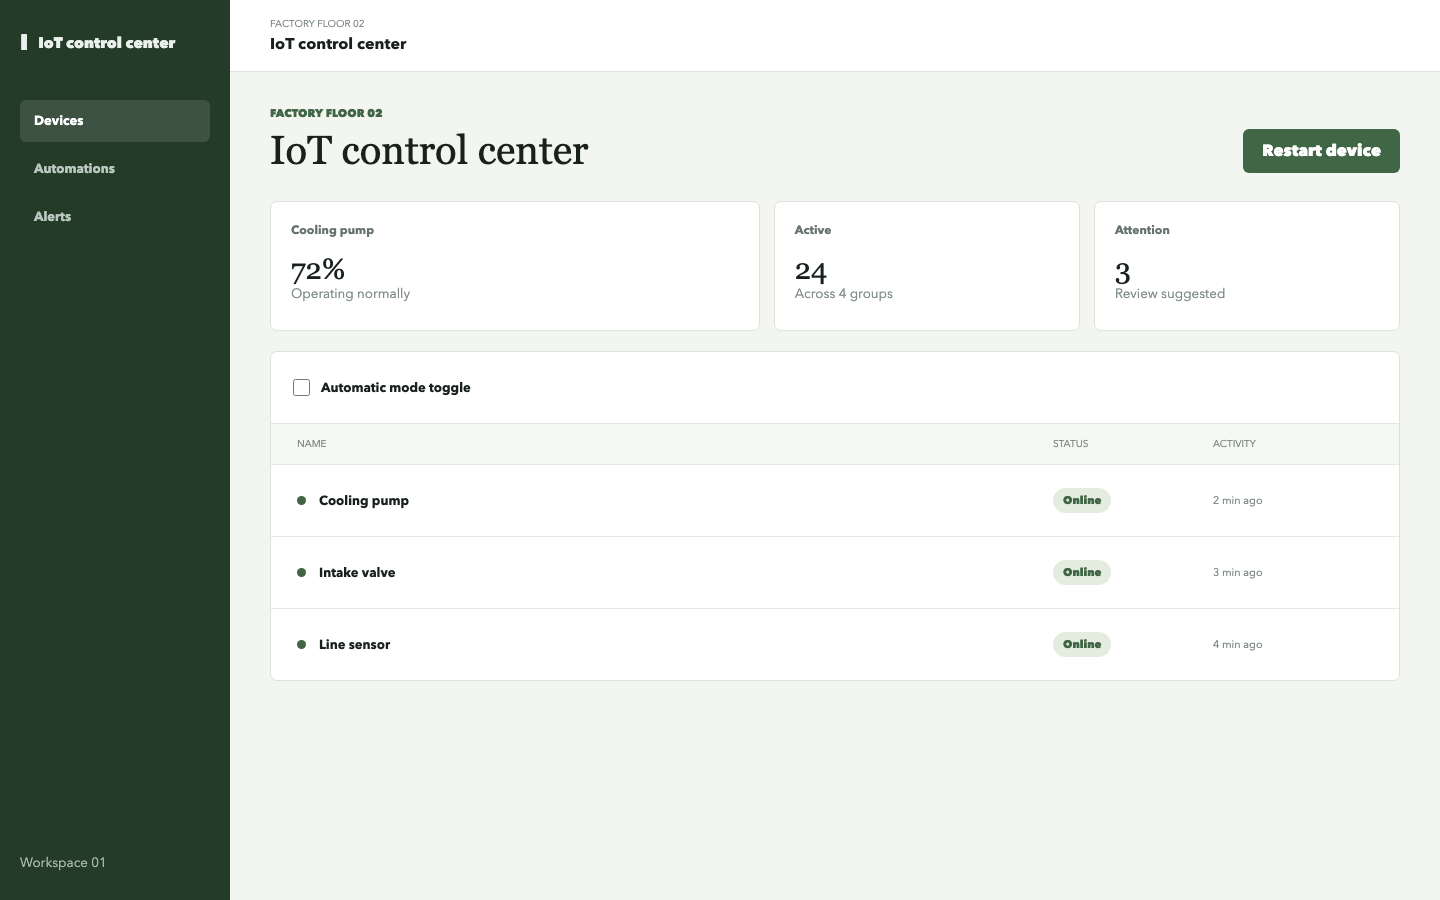
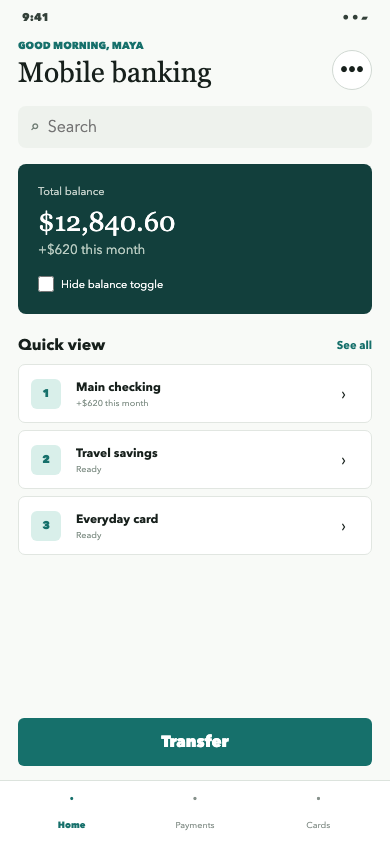
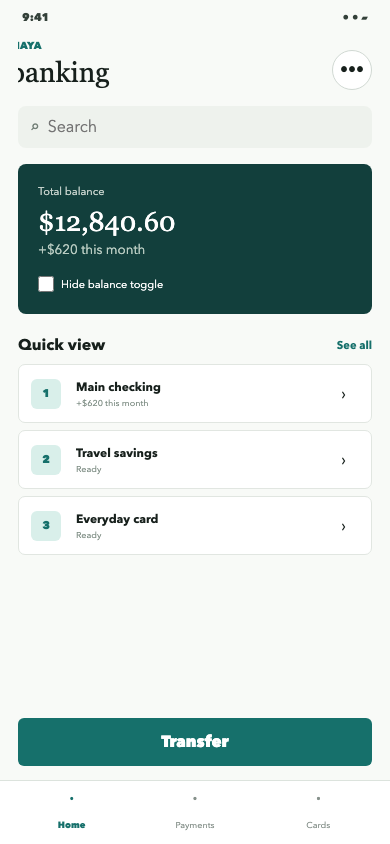
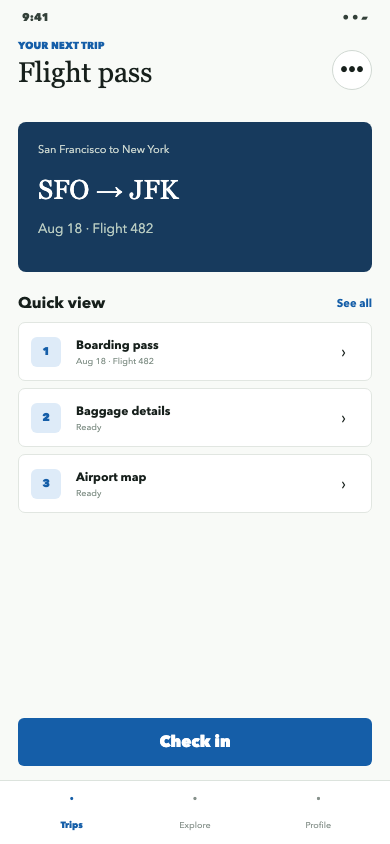
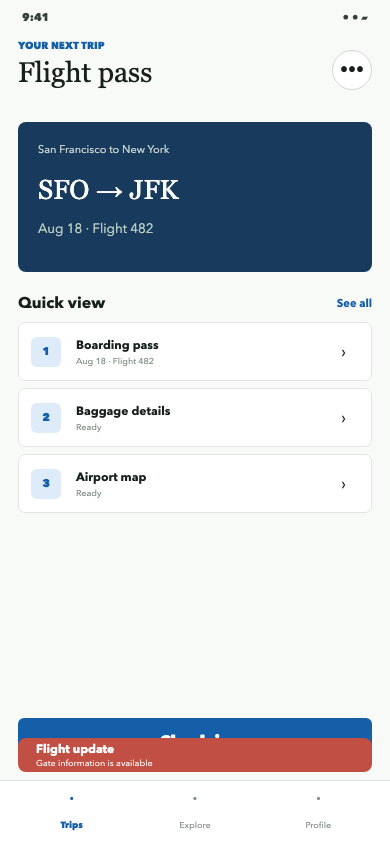
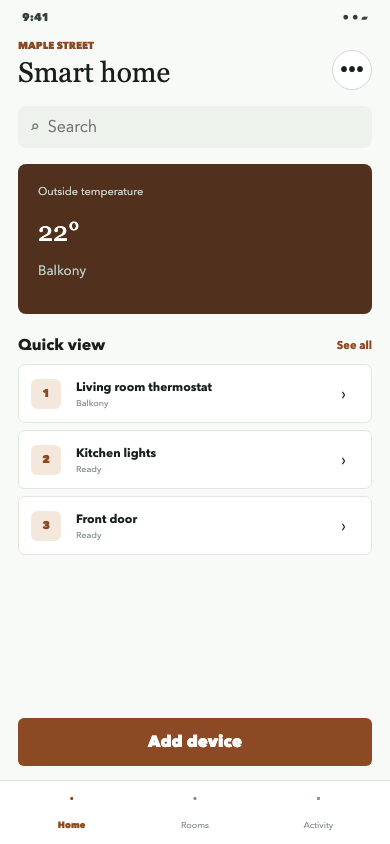
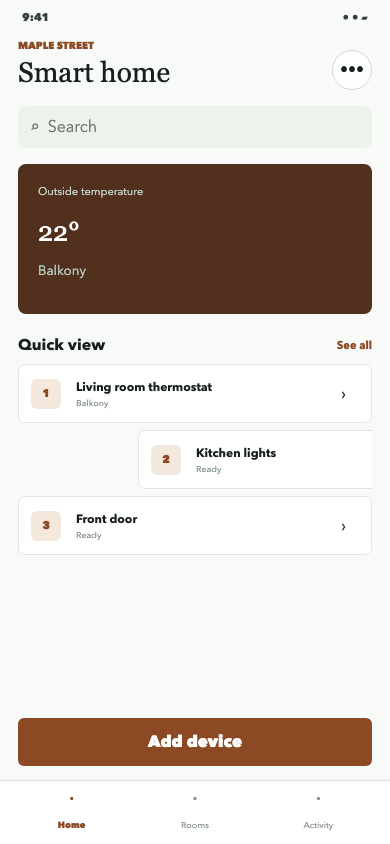
Jede Testvorrichtung verfügt über eine fehlerfreie Kontrolle und eine absichtlich fehlerhafte Variante. Die Aufnahmen nutzen feste Viewports, lokale Assets, stabile Zielgeometrie und exakte Grenzen für Pixeldifferenzen.
Modelldossiers
Öffne eine Modellseite für die Grounding-, Elementvorhandenseins-, Layoutfehler-, Latenz-, Zuverlässigkeits- und Kostenergebnisse. Die Routen bleiben auf den genannten Upstream-Anbieter festgelegt, Fallbacks sind deaktiviert.
Methodik
Die Abschnitte zu den Experimenten dokumentieren ihre jeweiligen Bewertungsregeln. Diese gemeinsame Methodik behandelt den gemeinsamen Eingabevertrag, Provider-Abläufe, den Forschungskontext und die Grenzen.
Eingabevertrag
Prompttext plus ein Base64-PNG – kein DOM, kein Barrierefreiheitsbaum, kein Quelltext, keine OCR, Tools, Plugins oder Websuche.
Chromium mit 1440 × 900 oder 390 × 844; Geräte-Skalierungsfaktor 1.
Browserbasierte Ground Truth in einem Koordinatenraum von 0–1000.
Fehlerfreie und fehlerhafte Varianten bewahren die Zielgeometrie und Capture-Hashes.
Vorgänge
Fixierte Modell-IDs, First-Party-Routen, deaktivierte Fallbacks und ein Antwortvertrag.
Ein Wiederholungsversuch bei 429, 5xx oder Netzwerkfehlern – nicht bei falschen Antworten.
Latenz, Fehler, Wiederholungsversuche und Kosten bleiben von der Genauigkeit getrennt.
Veröffentlichte Datensätze enthalten weder Schlüssel noch Anfragekennungen der Anbieter.
Limits, Daten und Lizenz
Sechs synthetische Screens, ein Durchlauf pro Fall und 24 Zielvorgaben können keine allgemeine Überlegenheit oder Stabilität belegen. Die Ergebnisse werden veröffentlicht, damit der Umfang und die einzelnen Antworten überprüfbar bleiben.
Jede Ausgabe enthält die exakten Modell-IDs, Datumsangaben, Prompt- und Schema-Hashes, Endpoint-Steuerungen sowie bereinigte Versuche, da sich Anbieter ändern. In den Rohaufzeichnungen der Modelle fehlen API-Schlüssel, Request-IDs und Generierungs-IDs.
Von Repeato erstellte Screenshots, Annotationen, Manifeste und aggregierte Ergebnisse sind verfügbar unter CC BY 4.0. Siehe die Hinweis zur Benchmark-Lizenz. Rohe Modellausgaben unterliegen weiterhin den Bedingungen ihrer Anbieter.